Wat kun je als hobbyist vandaag al onderzoeken met een echte quantumcomputer? In XXZham volgen we hoe een geordend patroon van 80 spins onder onderlinge interacties verandert. We gebruiken IBM Heron, vergelijken de gemeten curve met klassieke berekeningen en onderzoeken welke rol foutmitigatie speelt. Het doel is een reproduceerbare NISQ-demonstratie en een serieuze onderzoekskandidaat voor quantumvoordeel, niet de aankondiging van bewezen quantum advantage.
Onderzoeksstand: 21 september 2026. De hardwaremeting is uitgevoerd op 20 september; de klassieke convergentiecontrole op 21 september.
1. Van een magnetisch materiaal naar een spinketen
Een spin-1/2 heeft twee mogelijke uitkomsten wanneer we zijn magnetisatie langs een gekozen richting meten. Voor onze simulatie stellen we iedere spin voor door een qubit. De symbolen X, Y en Z zijn Pauli-operatoren: ze beschrijven verschillende componenten van de spin. De Hamiltoniaan vertelt hoe die spins elkaar beinvloeden en hoe de toestand in de tijd verandert.
We gebruiken een open keten: iedere spin koppelt aan zijn directe buur, maar de laatste spin koppelt niet terug aan de eerste.
H=H_{\mathrm{XXZ}}+H_f,
\qquad
H_{\mathrm{XXZ}}=\sum_{i=0}^{N-2}\left[J_{xy}(X_iX_{i+1}+Y_iY_{i+1})+J_zZ_iZ_{i+1}\right].
\]
De XX- en YY-termen laten naburige spins gezamenlijk veranderen: ze kunnen een lokale spinexcitatie uitwisselen. De ZZ-term geeft parallelle en antiparallelle configuraties verschillende energieen. De verhouding tussen Jz en Jxy bepaalt de uitwisselingsanisotropie. In onze test zijn beide gelijk aan 1: het isotrope uitwisselingspunt binnen de XXZ-familie, met daarnaast een plaatsafhankelijk veld.
H_f=\sum_{i=0}^{N-1}h_iZ_i,\qquad
h_i=0.5\cos(2\pi\beta i),\qquad
\beta=\frac{\sqrt{5}-1}{2}.
\]
Door de irrationale beta is dit veld quasiperiodiek: het heeft structuur, maar herhaalt zich niet met een vaste gehele roosterperiode. Zo kunnen we bestuderen hoe ruimtelijke variatie en interacties samen het verdwijnen van een beginpatroon bepalen. Dit is een vereenvoudigd model voor veeldeeltjesdynamica, geen berekening van de eigenschappen van een specifiek industrieel materiaal.
De opzet en bronimplementatie komen uit Imbalance_XXZ_hz_1D van Vishal Khatkar, Akash Yadav, Md. Osama Ali, Ritajit Majumdar, Rudranil Basu en Sambuddha Sanyal. Onze lokale implementatie bewaart hun code als ongewijzigde submodule op commit 8416e815da5d7a5df147a276b9f2434fef9626a8.
2. Imbalance: hoeveel beginpatroon blijft over?
We beginnen met een Neel-patroon: afwisselend 0 en 1. Dat is eenvoudig te prepareren door X-poorten op de oneven qubits toe te passen. Vervolgens laten we de keten evolueren. We meten niet de volledige golffunctie, maar een gewogen gemiddelde van de lokale magnetisaties:
I(t)=\frac{1}{N}\sum_{i=0}^{N-1}(-1)^i\langle Z_i(t)\rangle.
\]
Bij het ideale beginpatroon is I(0)=1. Als de afwisselende ordening verdwijnt, komt de imbalance dichter bij nul. Een tekenwisseling geeft aan dat de andere subroosteroriëntatie op dat moment overheerst. Een waarde rond nul bewijst op zichzelf geen volledige thermalisatie: een enkele observable vertelt niet alles over de toestand.
We onderzoeken alle 31 tijdpunten van t=0 tot t=5, met een afstand van 1/6. De tijd is uitgedrukt in modeleigen eenheden met hbar=Jxy=1. Het gaat dus niet om vijf seconden fysische evolutie. Rekentijd in seconden is een afzonderlijke grootheid.
3. Van tijdsevolutie naar een quantumcircuit
De exacte evolutie wordt beschreven door U(t)=exp(-iHt). Omdat naburige interactietermen in het algemeen niet commuteren, kunnen we dit niet zonder benadering vervangen door een product van alle afzonderlijke poorten. Trotterisering deelt de evolutie op in kleinere stukken.
Onze quantumroute gebruikt het interactiebeeld ten opzichte van het lokale veld:
U(t)=e^{-iH_ft}U_I(t),\qquad
H_I(t)=e^{iH_ft}H_{\mathrm{XXZ}}e^{-iH_ft}.
\]
Het veld verdwijnt daarmee niet uit de fysica. Het komt terug als een tijdafhankelijke fase in de uitwisselingsinteracties. De ZZ-term blijft onveranderd. De imbalance commuteert met het veld; de laatste veldrotatie verandert deze observable daarom niet. Dat helpt om het circuit gericht op de gevraagde meting te formuleren.
Per tijdinterval worden de interacties verdeeld over even en oneven verbindingen, met een symmetrische half-vol-half-volgorde: een halve even laag, een volledige oneven laag en een halve even laag. De broncode gebruikt daarbij intervalgemiddelde interacties, inclusief een sinc-factor voor het faseverloop. Ook zo blijft het een benadering: tijdordening en niet-commuterende interacties vragen controle.
Voor ieder gewenst eindtijdstip gebruiken we 20 Trotterstappen. De stapgrootte is dus t/20 en groeit met het eindtijdstip. De klassieke TEBD-run gebruikt juist een vaste kleinere tijdstap en hergebruikt de toestand langs de hele curve. Beide routes richten zich op dezelfde Hamiltoniaandynamica, maar voeren niet hetzelfde algoritme uit.
4. Waarom 80 spins klassiek niet automatisch onmogelijk zijn
Een algemene toestand van 80 qubits heeft 280 complexe amplituden. Een volledige toestandsvector is daardoor onpraktisch. Maar een klassieke simulator hoeft die representatie niet te kiezen.
Een matrix-product state, of MPS, schrijft de toestand als een keten van kleine tensoren. De bonddimensie chi begrenst hoeveel correlaties de representatie kan vasthouden. Voor een vaste chi schaalt het aantal tensorparameters ongeveer als N maal 2 maal chi-kwadraat. Bij N=80 en chi=16 is dat ongeveer 40.960 complexe getallen in de ruwe tensoren, exclusief werkgeheugen en software. De 80 fysieke spins blijven aanwezig; alleen de toegestane toestandsrepresentatie is sterk beperkt. Achtergrond over MPS.
TEBD evolueert zo’n MPS met lokale twee-spinbewerkingen en kapt de bonddimensie telkens af. Een hogere chi kan meer informatie behouden, maar kost meer rekentijd. TDVP is een andere tensor-netwerkroute. Pauli propagation werkt weer anders: die volgt de meetoperator in het Heisenbergbeeld en kan daardoor een sterke tegenstander zijn wanneer slechts enkele observabelen nodig zijn. Geen van deze benaderingen mag worden weggelaten alleen omdat die een quantumvergelijking minder gunstig maakt.
5. Wat mitigatie in onze hardwaremeting doet
NISQ betekent dat de processor nog ruisgevoelig is en geen volledige fouttolerante bescherming voor deze berekening gebruikt. Daarom combineren we verschillende maatregelen. IBM beschrijft deze technieken en hun beperkingen.
- Meetmitigatie met TREX: gerandomiseerde readout en kalibratie helpen systematische meetafwijkingen te corrigeren.
- Pauli twirling: equivalente gerandomiseerde poortvarianten maken coherente fouten beter behandelbaar. Ze verwijderen niet alle ruis.
- XY4 dynamical decoupling: X- en Y-pulsen tijdens geschikte wachttijden onderdrukken bepaalde verstoringen. Dit is foutonderdrukking, geen foutcorrectie.
- Zero-noise extrapolation, ZNE: we meten bij ruisfactoren 1,0, 1,2 en 1,4 en extrapoleren lineair naar de denkbeeldige nulruislimiet.
I(\lambda)\approx a+b\lambda,\qquad I_{\mathrm{ZNE}}\approx a.
\]
Deze formule toont het extrapolatieprincipe; de Runtime-verwerking kan op afzonderlijke observabletermen werken. De nulruiswaarde wordt niet rechtstreeks gemeten. Afwijking van het lineaire model kan bias geven en extrapolatie kan statistische ruis versterken. Meer shots lossen dat modelprobleem niet vanzelf op.
Onze geslaagde run gebruikte 2.048 shots per ruisfactor, verdeeld over 32 randomisaties van elk 64 shots. De combinatie van mitigatie en suppression is onderdeel van het resultaat, niet een optionele voetnoot. De opgeslagen factor-1-uitkomsten geven ongeveer 0,0645 RMSE tegenover de TN-consensus; de volledige ZNE-uitkomst geeft 0,03694. Bij factor 1 blijven de overige maatregelen actief: dit is dus geen vergelijking met volledig onbewerkte hardware.
6. Onze eigen meting naast klassiek
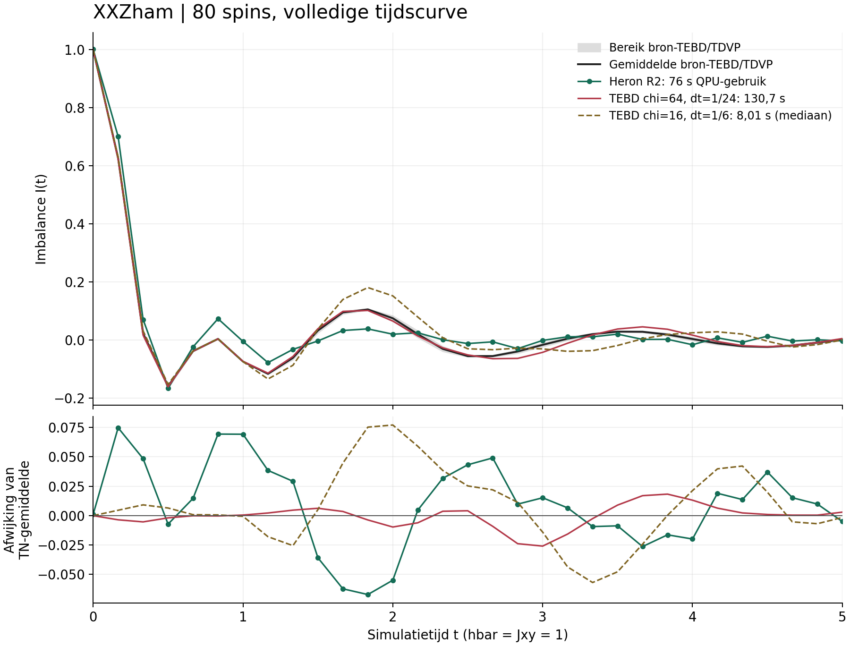
De hardwaremeting draaide op IBM Kingston, Heron R2, binnen het Open-plan. Er waren 31 N80-punten en drie N12-controles. Voor de onderstaande fouten gebruiken we steeds dezelfde referentie: het rekenkundig gemiddelde van de oorspronkelijke TEBD- en TDVP-curves. Dat gemiddelde is geen exacte oplossing.
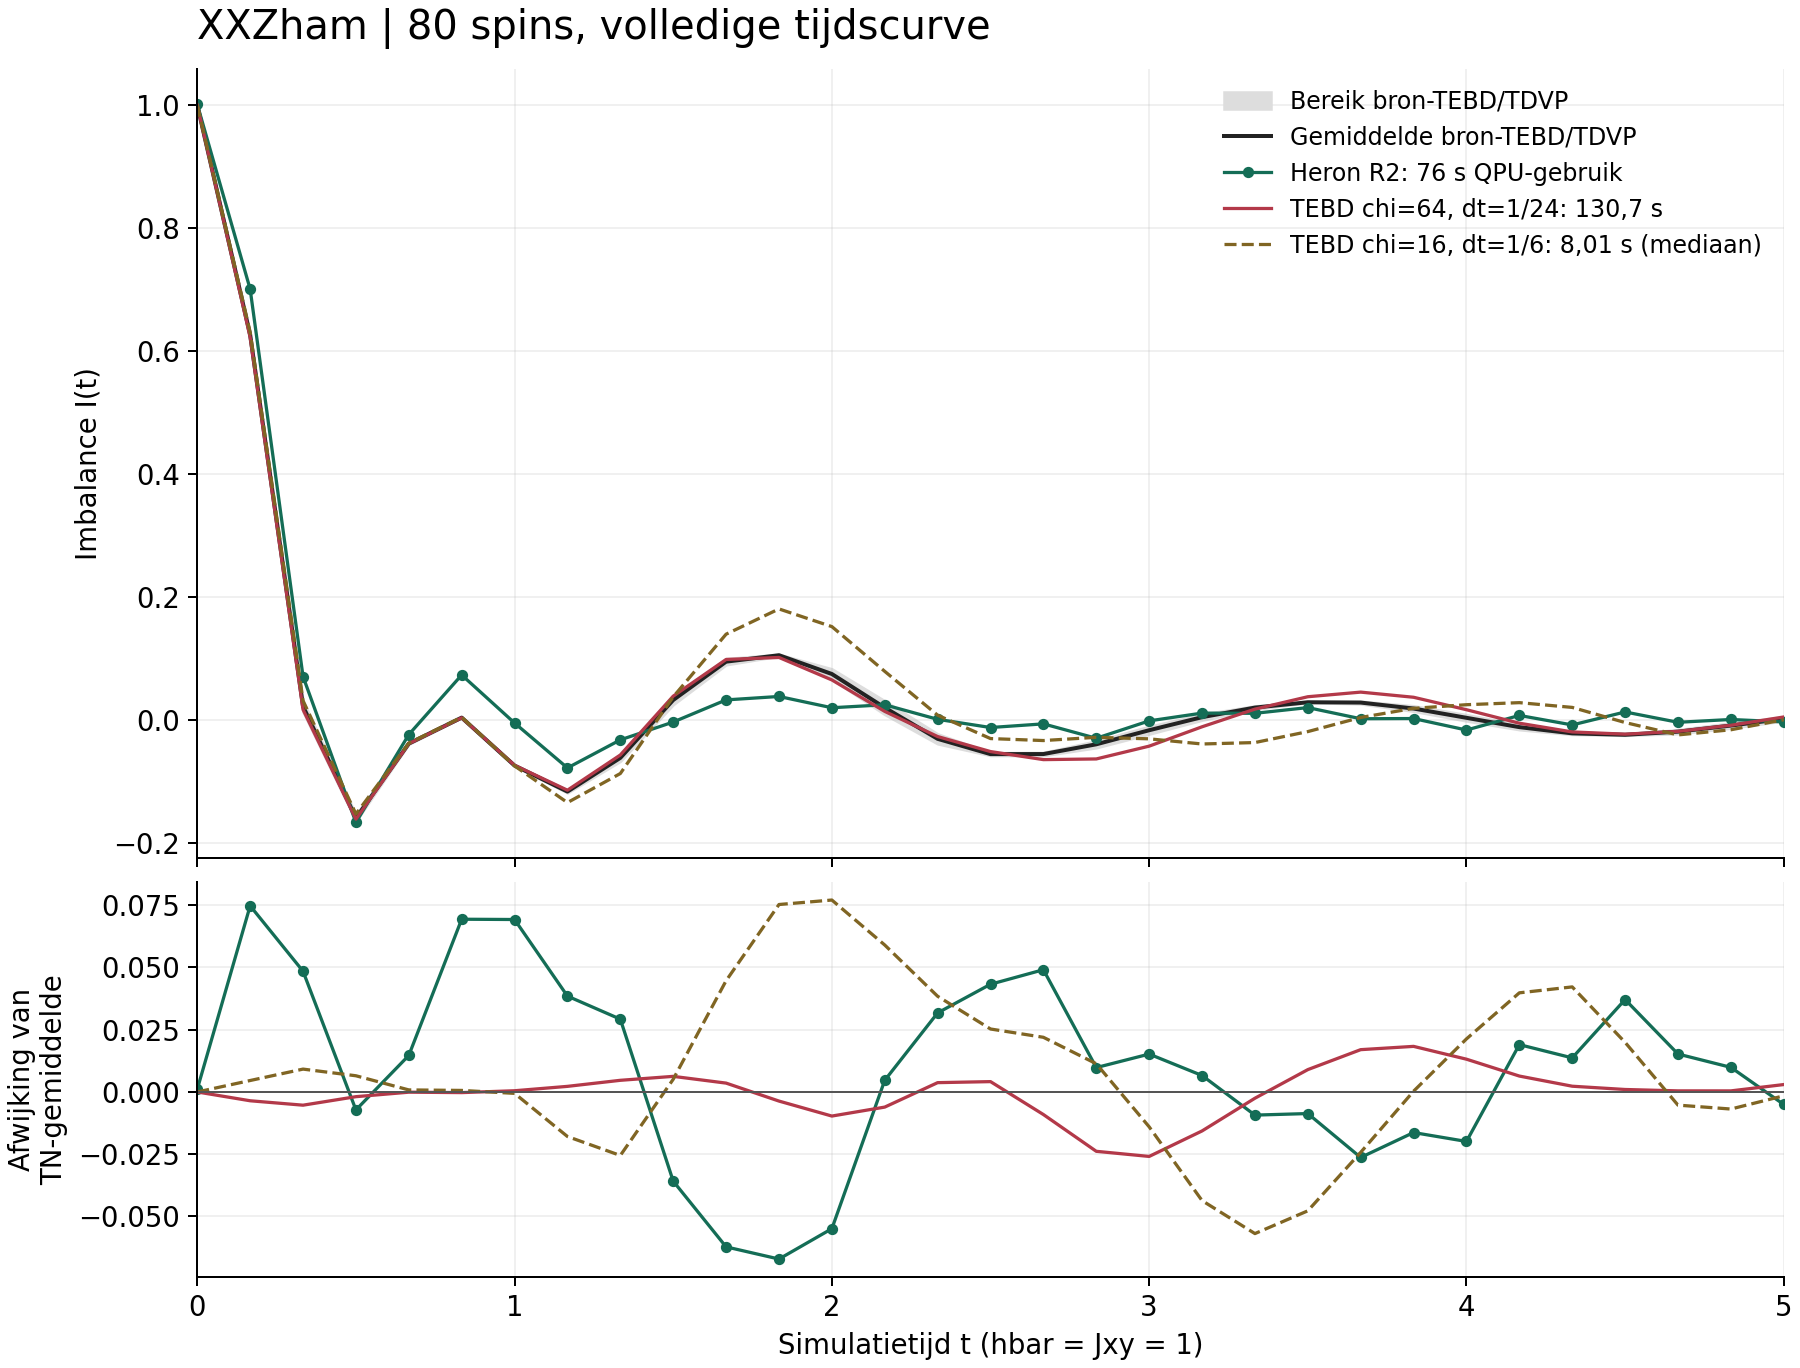
| Berekening | Tijd | RMSE | Maximale afwijking |
|---|---|---|---|
| Heron R2, met mitigatie | 76 s QPU-gebruik | 0,03694 | 0,07476 |
| Lokale TEBD, chi=64, dt=1/24 | 130,7 s uitvoering | 0,00951 | 0,02589 |
De verhouding 130,7/76 is ongeveer 1,72. Onze quantumrun gebruikte minder QPU-seconden dan deze verfijnde klassieke run aan CPU-uitvoeringstijd vroeg, met een grotere afwijking. Dat is een concrete vergelijking tussen twee gemeten instellingen, geen bewezen versnelling bij gelijke kwaliteit. QPU-gebruik omvat hier ook de kleine controlecircuits; het is niet hetzelfde als CPU-uitvoeringstijd of totale doorlooptijd.
IBM registreerde daarnaast 66,93 seconden circuituitvoering. Tussen indiening en afronding verstreken ongeveer 46 minuten; de lokale voorbereiding kostte 56,17 seconden. De klassieke run kostte inclusief processtart en voorbereiding 133,95 seconden. De klassieke computer was een AMD Ryzen 5 3500U, met een CPU-thread in de bekende Qiskit/Quimb-omgeving. Dit is geen vergelijking met de snelst beschikbare klassieke hardware.
Er is ook een veel goedkopere klassieke benadering: chi=16 en dt=1/6 berekende dezelfde 31 tijdpunten in mediaan 8,01 seconden over vijf runs. Die voldeed aan onze ruime oorspronkelijke foutcriteria tegenover beide broncurves, maar faalde een afzonderlijke convergentietest. Ook de verfijnde chi=64-run is nog niet aangetoond geconvergeerd. Alle negen convergentieruns samen kostten 446,2 seconden. Die totale controletijd is niet de tijd van een enkele klassieke simulatie.
Een latere quantumproef met een limiet van 40 seconden werd afgebroken en leverde geen volledige curve op. De geslaagde demonstratie in dit artikel is de 76-secondenrun, niet die afgebroken poging.
7. De oorspronkelijke inzending en onze uitbreiding
De oorspronkelijke auteurs rapporteerden 297 seconden op Heron R3, tegenover 1.673,49 seconden voor Pauli propagation op een NVIDIA H200. Ook TEBD en TDVP zijn opgenomen. Onze eigen hardware, shotinstellingen en timingregistratie verschillen van die bronproef; 297/76 is daarom geen zuivere optimalisatiesnelheid. De oorspronkelijke TEBD-tijd van 16.649,28 seconden omvat bovendien een reeks bonddimensies, niet alleen een goedkope gekozen run.
De Tracker-inzending #244 staat bij controle op 21 september 2026 open, met projectstatus Backlog en zonder verified-label. Het project is voorgesteld als actieve kandidaat. Onze bijdrage bestaat uit een eigen hardwaremeting, lokale klassieke tegenproeven, expliciete timinguitsplitsing en onafhankelijke controle van de opgeslagen cijfers.
De oorspronkelijke repository is openbaar. Onze werkrepository BramDo/XXZham is op dit moment prive. De eigen curvegegevens bij deze publicatie zijn daarom ook als CSV bij dit artikel beschikbaar. Daarmee kunnen lezers de getoonde curves en afwijkingen narekenen; het CSV-bestand alleen bevat niet het volledige uitvoerbare experiment.
8. Waarom nieuwere hardware interessant blijft
Dit onderzoek hoeft niet te wachten op volledige fault tolerance. IBM rapporteert voor Nighthawk r2 tot 25 maal hogere circuitdoorvoer dan Heron en een 12-voudige versnelling in een specifieke neutronenverstrooiingssimulatie. De snelle, onafhankelijke qubitreset is daarbij belangrijk. Dat ondersteunt het nut van experimenteren met steeds betere NISQ-machines. IBM over Nighthawk r2.
Deze cijfers zijn geen gemeten voorspelling voor XXZham. Foutcorrectie vraagt extra qubits en bewerkingen, terwijl zij dure mitigatieherhalingen kan verminderen. Of een fault-tolerante uitvoering van dit specifieke probleem sneller is, hangt van architectuur, algoritme en foutdoel af. Nighthawk ondersteunt onderzoek aan foutcorrectie, maar maakt een willekeurig circuit niet automatisch fouttolerant. Van mitigatie naar foutcorrectie.
Een goede kandidaat om verder te onderzoeken
Voor een hobbyist is hier al veel bereikt: een echt 80-spinexperiment, een interpreteerbare fysieke observable, inzicht in mitigatie en een vergelijking die ook ongunstige klassieke tegenresultaten zichtbaar houdt. Dat maakt XXZham een goede onderzoekskandidaat, ook zonder bewezen quantum advantage.
In een toekomstige uitbreiding van onze Advantage List willen we zulke kandidaten apart houden van resultaten die aan de criteria voor aangetoond voordeel voldoen. Dit artikel loopt inhoudelijk op dat onderscheid vooruit; de nieuwe lijstcategorie is nog niet ingevoerd. De vervolgvraag blijft concreet: welke combinatie van circuit, mitigatie en hardware levert een bruikbare curve met de beste verhouding tussen kwaliteit en rekentijd?
[…] on September 21, 2026 by Nederlands […]